判断だけを返すAI「Jev」を不動産物件の自動分類に適用 ― TypeSafe AI の System One モデルで業種・こだわり条件のタグ付けを実地検証
資料の記載に反する判定は344マス中4件、同一入力でのぶれ0.06%、160件の分類を5〜6秒で処理
株式会社PERVA(本社:東京都中央区/ITカンパニー)は、TypeSafe AI が2026年9月に公開した System One モデル「Jev」を事業用不動産の物件分類に適用し実データによる検証を進めています。文章を生成せず判断と確率だけを返すモデルで、物件ごとの出店可能業種と設備条件を自動でタグ付けする仕組みです。実案件のデータで精度と実用性を確かめる段階にあり検証結果をテクニカルノートとしてまとめました。
背景
事業用テナントを探すお客様が最初に確かめるのは「この物件で自分の業種が開業できるか」です。ところが物件資料には決まった書式がなく、記載の粒度も出どころによってばらつきます。同じ「飲食店可」でも重飲食まで含むのか軽飲食までなのかは資料から読み取れないことが少なくありません。
答えの型を決めずに文章で返させると、資料に書かれていないことまで書けてしまいます。断定して表示した内容が現地で覆ると信用に直結します。そこで当社は答えの型をあらかじめ決めて渡し、モデルは選択肢と確率だけを返すという方式を検証しました。
ただし型を決めれば安全になるわけではありません。根拠の記載が無くても選択肢は選べるからです。実際に何を選ぶかを決めているのは、選択肢ごとに書いた規則のほうでした。
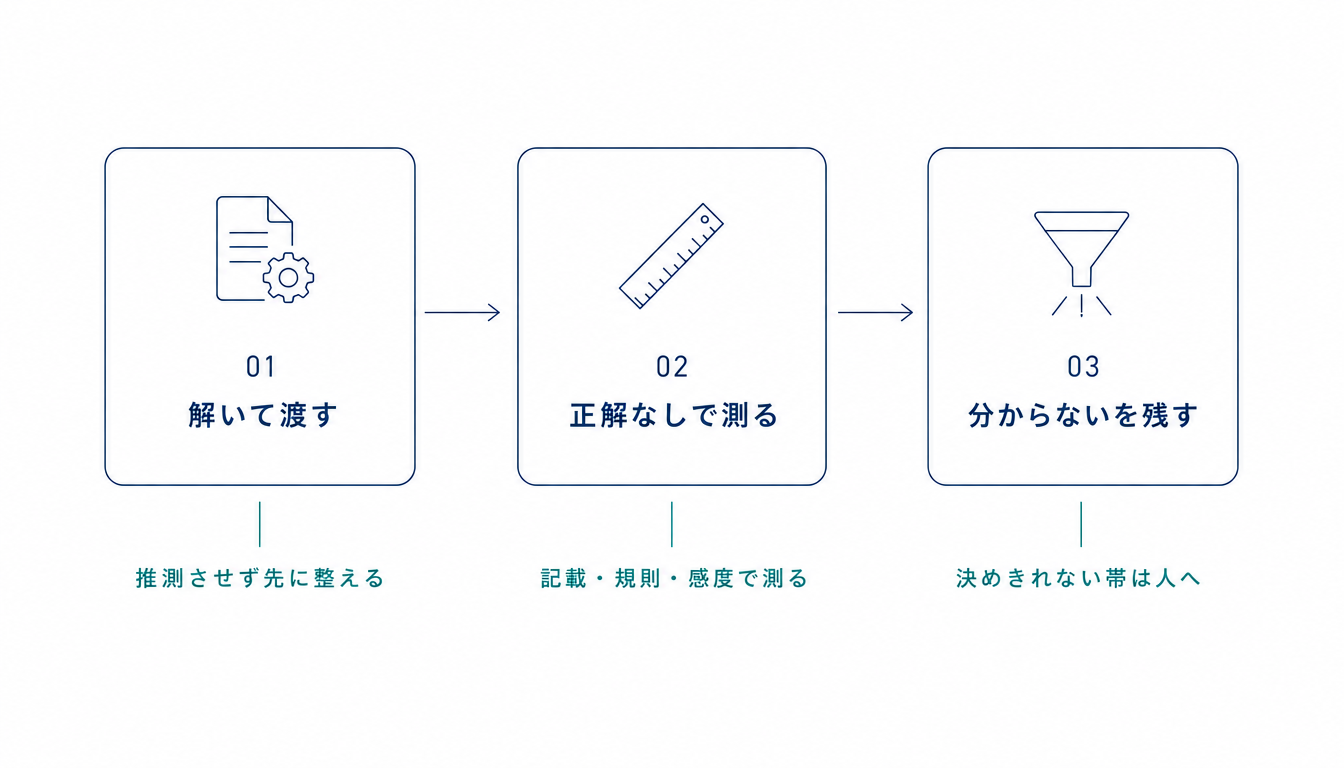
本AIが担う役割
01 解いて渡す ― 推測させる前に、こちらで整える
Jev は推論の途中経過を作らず一度で確率を返すため、渡す情報の作り方がそのまま判定の質になります。所在階の文字列は実データ160件で126種類ありました。書式そのものは14パターンで残りは階数の組み合わせです。少数の規則で解けるにもかかわらず文字列のままでは一致しないため、所在階・建物階数・地下の有無に解いてから渡しています。整理済みの要約に加えて解釈しない粗い書き起こしも併せて渡すことで、要約に残らなかった事実まで拾えるようになりました。
02 正解なしで測る ― 一致率を精度と呼ばない
実データを調べたところ、判定1,600マスのうち77.9%には根拠になる記載そのものがありませんでした。正解が存在しない領域で一致率を計算しても精度にはなりません。そこで採点を3本立てにしています。①資料の記載に反していないか、②言語化済みの事業ルールに反していないか、③資料を書き換えたとき判定が正しい方向へ動くか。
結果は記載違反4件(採点できる344マス中1.2%)・書き換えへの反応148件中148件・同一入力でのぶれ0.06%でした。ここで分かったのは二律背反です。事業ルールを規則として書き足す前の版は記載違反0件でしたが、その版は言語化済みの事業ルールに180件反していました。規則を足すとルール違反は5件まで減る一方、記載に反する判定が4件出ます。資料への忠実さと業務要件は同時にゼロにできません。どちらを優先するかを先に決め、残る側を数えられる形にしておくことが要点になります。
03 分からないを残す ― 決めきれない帯を人へ渡す
判定は「できます」「ご相談ください」「難しいかもしれません」の3値にしました。2値では判断のつかないものが「該当しない」に吸収されるため、落ちたことに誰も気づけません。実データでは判定の63.4%が「ご相談ください」に入ります。この帯を型として残すことで取りこぼしを検知できる形になりました。なお記載が1つも無い1,246マスのうち345マス(27.7%)では断定が返ります。用途区分や所在階から判断してよいと規則で決めた分であり、記載が無ければ必ず保留になる作りにはしていません。
卸売業への横展開
この仕組みが効くのは不動産に限りません。決まった書式ではないテキストが大量に届きそれを決まった型に仕分けたい業務であれば構造は同じで、卸売業はその代表格にあたります。ある調査では従業員400名規模の電材卸で月2万件の受注が発生しそのうち6割が電話とファクスで届いていると報告されています(出典:中小企業庁「令和3年度 中小企業の受発注のデジタル化推進方策に関する調査」)。
受注ファクスの一次仕分けに当てはめる
渡すものは3種類に分けます。解いた情報として取引先コード・商品マスタを突合した候補・正規化した数量と単位・年月日に分けた納期。生の情報としてOCRの粗い書き起こし。そして集計値や日付の前後比較は渡しません。計算はコード側に残します。
聞くことは1回のリクエストにまとめます。担当部署はどこか、商品マスタのどれか、緊急度はどうか。ここまでが選択肢を選ぶ質問です。加えて特別な取引条件が書かれているか、手書きの追記があるかを真偽で聞きます。
返ってくるのは選択肢と確率だけで、どれを自動処理に流すかはコード側が決めます。3つとも確信度が高く特別条件も手書きも低い伝票だけを基幹システムへ流し、候補が割れたものは担当者の確認待ちへ、特別条件や手書きが立ったものは必ず人が見る。この振り分けを外に出しておくと閾値を動かすだけで自動化率を調整できます。
同じ型が使える業務
取引先が書いた商品名から自社カテゴリを割り当てる、返品の受付メモを品質・物流・受発注に一次分類する、取引履歴の定性メモから与信の区分を出す。いずれも今回と同じ型が使えます。先行事例でも全件を自動化するのではなく特別な取引条件は人が介在するハイブリッド型が採られてきました(出典:トラスコ中山「AIへの取り組み」2025年12月末時点)。読めないものと決めきれないものは必ず残るため、それを型として持つ設計が要点になります。
着手するときの順番
まず割れない粒度を決めます。200分類を一度に聞くと確率が割れるため20分類程度に束ねてから実データで確かめます。次に正解が無い層がどれだけあるかを数えます。不動産では判定マスの77.9%に根拠の記載がありませんでした。ここを数える前に精度の議論を始めても噛み合いません。そして「分からない」の帯を最初に作ります。自動化率は後から上げられますが取りこぼしは後からでは気づけません。
今後の展開
当社は本方式を自社の事業用不動産サービスへ順次適用し同じ型を他業種の業務へ展開していきます。対象は卸売業の受発注・商品マスタ、与信や取引条件の見直し、問い合わせの一次仕分けなどです。あわせて「VADO AI」との連携により判定結果を業務フローへ直接つなぐ構成も検討しています。
検証の詳細は、テクニカルノート「判断だけを返すAI ― TypeSafe AI「Jev」実地検証レポート」(A4横・11ページ/PDF)にまとめました。
お問い合わせ先
株式会社PERVA ITカンパニー
TEL:03-6428-7357
MAIL:info@perva.co.jp
問い合わせ:https://perva.co.jp/contact